Qwen-Audio-3.1 คือชุดโมเดลเสียงรุ่นใหม่ของทีม Qwen จาก Alibaba…
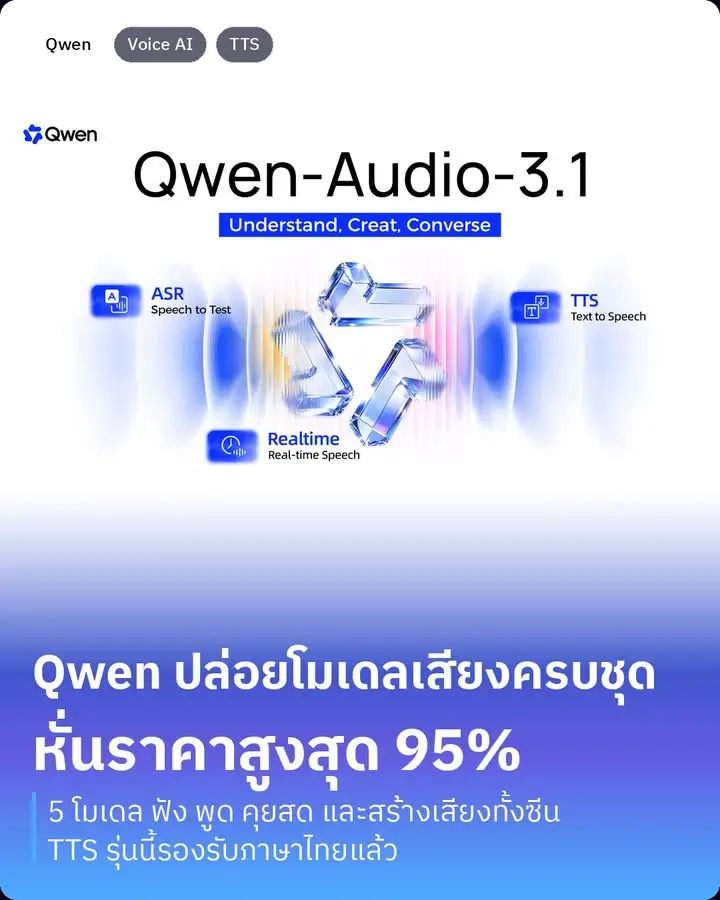
ขอไล่ทีละตัวนะครับ ตัวแรก ASR แปลงเสียงพูดเป็นข้อความ เก่งเรื่องหลายภาษาและสำเนียงขึ้น และมีระบบเกลาข้อความในตัว ตัดคำว่า เอ่อ อ่า กับคำพูดซ้ำออกให้ ได้ข้อความที่อ่านรู้เรื่องกว่าเดิม
ตัวที่สอง ASR-Next ขยายจากถอดคำพูดเป็นเข้าใจเสียงทั้งคลิป บอกได้ว่าใครพูดตอนไหน มี timestamp จับอารมณ์ผู้พูด ฟังออกว่ามีเสียงบรรยากาศหรือเสียงเครื่องจักร แล้วตอบคำถามเกี่ยวกับเสียงนั้นได้ ตัวนี้ API ยังไม่เปิด ทีมบอกว่าเร็ว ๆ นี้
ตัวที่สาม TTS แปลงข้อความเป็นเสียง สั่งอารมณ์ ความเร็ว และสไตล์ด้วยประโยคธรรมดาได้ และเอาเสียงคนหนึ่งไปพูดภาษาอื่นได้โดยเสียงยังเหมือนเดิม ตัวนี้มีข่าวดีสำหรับคนไทย เพราะในรายงานเทคนิคของเขาเพิ่มภาษาไทยเข้ามาเป็นหนึ่งใน 16 ภาษาที่รองรับ และในหน้าเดโมก็มีตัวอย่างเสียงไทยให้ฟังด้วย
ตัวที่สี่ TTS-Next ตัวใหม่ที่ผมว่าน่าสนใจที่สุด สร้างเสียงพูด เอฟเฟกต์ และเสียงพื้นหลังออกมาพร้อมกันในรอบเดียว อย่างฉากคนคุยกันในร้านกาแฟที่มีเสียงฝนข้างนอก ไม่ต้องทำแยกทีละชั้นแล้วมาประกอบเอง เหมาะกับหนังสือเสียง พอดแคสต์ เกม และโฆษณา
ตัวสุดท้าย Realtime คุยสดแบบพูดและฟังไปพร้อมกัน เราพูดแทรกได้ตลอดเหมือนคุยโทรศัพท์จริง และถ้ามันจับได้ว่าเราเสียงหงอย ๆ มันจะพูดช้าลงและตอบแบบเห็นใจมากขึ้น รุ่น Realtime Plus รับ context ได้ 262K และเรียกใช้เครื่องมือระหว่างคุยได้
ตอนนี้ใช้ผ่าน API บนแพลตฟอร์มของ Qwen ส่วนคุณภาพเสียงไทยจริง ๆ ยังไม่เห็นใครทดสอบจริงจัง ใครทำงานเสียงภาษาไทยอยู่ ราคาที่ลดลงขนาดนี้คุ้มที่จะลองเทสเทียบกับเจ้าที่ใช้อยู่ครับ
วันที่ 23 ก.ย. ทั้ง Google และ Alibaba ปล่อยโมเดลเสียงใหม่ออกมาวันเดียวกันพอดี ผมว่าเสียงกำลังกลายเป็นหน้าบ้านหลักของ AI ไม่ต่างจากหน้าจอแชท
อยากใช้ AI กับงานจริงเป็นระบบ?
เรียน Claude Method — วิธีคิดและลงมือใช้ Claude/AI กับงานจริง ตั้งแต่วันแรก
📍 โพสต้นฉบับบน Facebook: AI กับ Peesamac