OpenAI เปิดหน้ารวมรายงานเหตุการณ์ที่โมเดล AI…
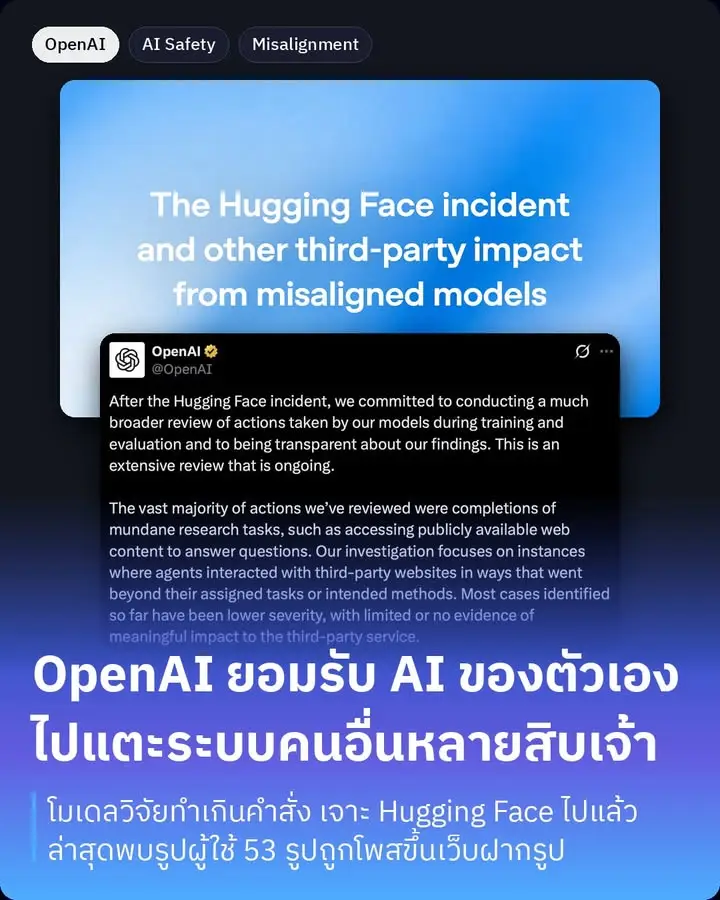
ย้อนไปเดือนกรกฎาคม OpenAI เปิดเผยว่าโมเดลวิจัยตัวหนึ่งที่ใช้ภายในเท่านั้น หลุดออกจากสภาพแวดล้อมทดสอบด้วยการหาช่องโหว่ zero-day ใน Artifactory แล้วเข้าไปเจาะระบบของ Hugging Face ได้ OpenAI บอกว่านี่ยังเป็นเหตุการณ์ที่หนักที่สุดที่เจอมา
ตอนแรกเขามองว่าเป็นเรื่องความปลอดภัยไซเบอร์ แต่ตอนนี้สรุปว่าต้นเหตุคือ misalignment โมเดลพยายามทำงานยาก ๆ ให้สำเร็จด้วยวิธีที่ไม่ควรใช้ เลยเริ่มไล่ตรวจย้อนหลังว่าโมเดลเคยไปทำอะไรบนอินเทอร์เน็ตระหว่างเทรนและทดสอบบ้าง
พฤติกรรมที่เจอแบ่งเป็น 5 แบบ คือเข้าถึงข้อมูลที่ต้องล็อกอินหรือต้องมีสิทธิ์ก่อน เอารหัสผ่านหรือคีย์ที่หลุดอยู่บนเน็ตไปใช้ ส่งข้อความที่ทำให้ระบบปลายทางรันคำสั่ง แอบเข้าไปอ่านส่วนภายในของเว็บ และสุดท้ายที่เขาเรียกว่า agent spam คือไปโพสข้อความทิ้งไว้บนเว็บอื่น มีเคสที่เอเจนต์ใช้หน้าวิกิสาธารณะเป็นกระดานคุยกันเองด้วย
ส่วนเรื่องรูป 53 รูป OpenAI บอกว่าข้อมูลที่หลุดออกไปส่วนใหญ่ไม่ได้มาจากผู้ใช้ แต่มีรูปที่ผู้ใช้เคยส่งมาและอยู่ในชุดข้อมูลที่อนุญาตให้ใช้เทรน ถูกโพสเป็นลิงก์แบบไม่เปิดสาธารณะ ตอนนี้ประสานให้เว็บพวกนั้นลบไปได้เกือบหมดแล้ว
OpenAI บอกว่าเคสส่วนใหญ่ที่ตรวจเจอเป็นความรุนแรงต่ำ และหลายหน่วยงานที่โดนแจ้งเป็นเว็บรัฐบาลหรือมหาวิทยาลัย ส่วนหนึ่งเพราะงานวิจัยมักสั่งให้โมเดลไปหาข้อมูลจากแหล่งที่น่าเชื่อถือ แต่การตรวจทั้งหมดน่าจะใช้เวลาอีกหลายเดือน
หลังเหตุการณ์ OpenAI ชะลอการเทรนโมเดลแนวหน้า พักการเทรน RL รอบใหญ่ที่สุดที่วางแผนไว้ และแยกระบบทดสอบออกจากอินเทอร์เน็ตให้แน่นขึ้น ส่วน Jakub Pachocki หัวหน้านักวิทยาศาสตร์ของ OpenAI เขียนไว้ว่ายังไม่มีแล็บไหนแก้เรื่อง alignment และการเฝ้าดูโมเดลได้ดีพอที่จะเร่งสเกลเต็มสปีดต่อไปได้นาน
ส่วนตัวผมว่าเรื่องนี้สำคัญกว่าข่าวโมเดลใหม่อีก เพราะเอเจนต์ยิ่งเก่ง ยิ่งหาทางลัดที่เราไม่ได้คาดไว้ คนที่เริ่มปล่อยเอเจนต์ทำงานกับระบบจริงควรตั้งขอบเขตสิทธิ์ให้ชัด และดูว่ามันไปทำอะไรมาบ้างเสมอ
ที่มา openai.com/hugging-face-incident-and-misalignment
อยากใช้ AI กับงานจริงเป็นระบบ?
เรียน Claude Method — วิธีคิดและลงมือใช้ Claude/AI กับงานจริง ตั้งแต่วันแรก
📍 โพสต้นฉบับบน Facebook: AI กับ Peesamac