Grok 4.7 โมเดลใหม่ของ SpaceXAI ที่ออกมาวันนี้…
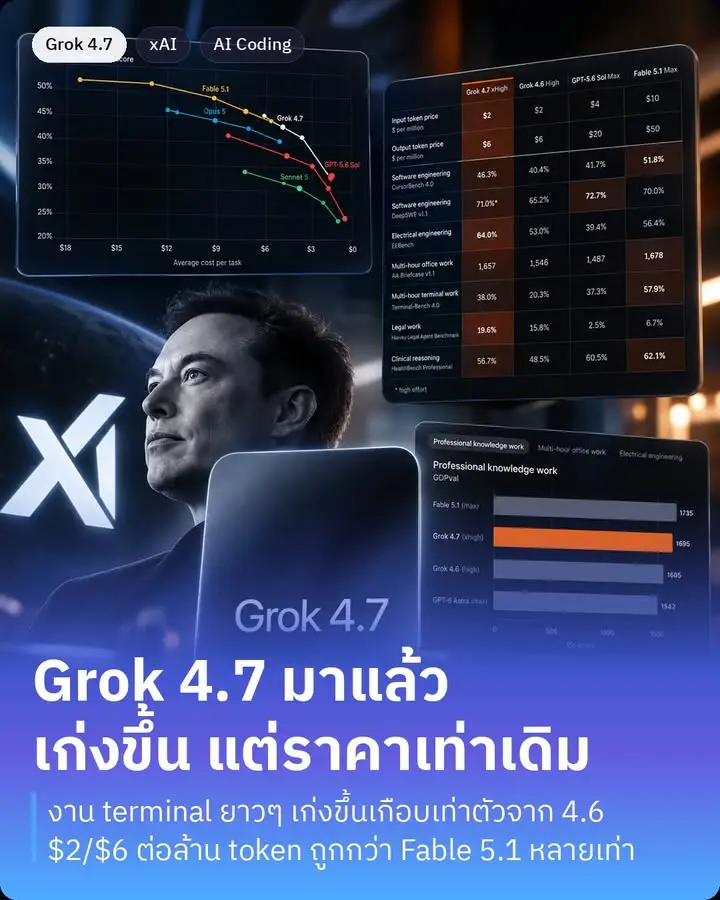
ราคาเริ่มที่ $2 ต่อล้าน input token และ $6 ต่อล้าน output token ถ้าเทียบในตารางของเขาเอง GPT-5.6 Sol อยู่ที่ $4/$20 ส่วน Fable 5.1 อยู่ที่ $10/$50 ห่างกันหลายเท่าอยู่ครับ
เบื้องหลังคือเปลี่ยนไปใช้ base model ที่ใหญ่ขึ้น แล้วเทรน reinforcement learning นานขึ้นบนงานที่ยากกว่าเดิม โดยเน้นโจทย์ที่ต้องทำกันหลายชั่วโมง ผลที่ได้คือมันทำงานได้นานขึ้นก่อนจะยอมแพ้ ตรวจงานตัวเองละเอียดขึ้น และรับมือ context ยาวๆ ได้ดีขึ้น
ตัวเลขที่ผมว่าเด่นสุดคือ Terminal-Bench 4.0 ซึ่งวัดงานใน terminal ที่กินเวลาหลายชั่วโมง ขึ้นจาก 20.3% เป็น 38% เกือบเท่าตัว งานวิศวกรรมไฟฟ้า (EEBench) ก็ขึ้นจาก 53% เป็น 64% แซงทั้ง GPT-5.6 Sol และ Fable 5.1 ส่วนงานกฎหมายใน Harvey Legal Agent Benchmark ได้ 19.6% นำคนอื่นในตาราง
แต่ก็ยังไม่ได้ชนะทุกสนาม Fable 5.1 ยังนำใน CursorBench 4.0 (51.8% vs 46.3%) และทิ้งห่างใน Terminal-Bench (57.9% vs 38%) จุดที่ xAI ชูจริงๆ คือความคุ้ม เพราะบน CursorBench ต้นทุนเฉลี่ยต่องานต่ำกว่าคู่แข่งมาก
อีกเรื่องที่เขาเน้นคือความปลอดภัย ทำ safeguard ใหม่หมด บน HackerBench ปล่อยคำขอ cyber ที่เสี่ยงผ่านไปแค่ 3.3% แต่แทบไม่บล็อกงาน security ปกติ และยังให้พาร์ทเนอร์ด้าน cybersecurity บางเจ้าได้ใช้ความสามารถ red-team แบบ invite-only เพื่องานป้องกัน
ใช้ได้แล้ววันนี้ใน Cursor, Grok Build และ Grok API มีตัว fast ด้วย เร็วขึ้น 2 เท่าแต่ราคาก็คูณ 2 เหมือนกัน
ส่วนตัวผมมองว่าเกมตอนนี้ไม่ได้อยู่ที่ใครฉลาดสุดแล้ว แต่อยู่ที่ว่าปล่อยให้ AI ทำงานเองได้นานแค่ไหนก่อนคนต้องเข้าไปช่วย และจ่ายเท่าไหร่ต่องาน Grok 4.7 เลือกเล่นมุมราคาชัดเจน ใครใช้ Cursor อยู่ลองสลับมาเทียบกับงานจริงดูครับ เพิ่งออกไม่กี่ชั่วโมง รีวิวจริงน่าจะตามมาอีก 1-2 วัน
อยากใช้ AI กับงานจริงเป็นระบบ?
เรียน Claude Method — วิธีคิดและลงมือใช้ Claude/AI กับงานจริง ตั้งแต่วันแรก
📍 โพสต้นฉบับบน Facebook: AI กับ Peesamac