Eleven v4 คือโมเดลเสียงตัวใหม่ของ ElevenLabs…
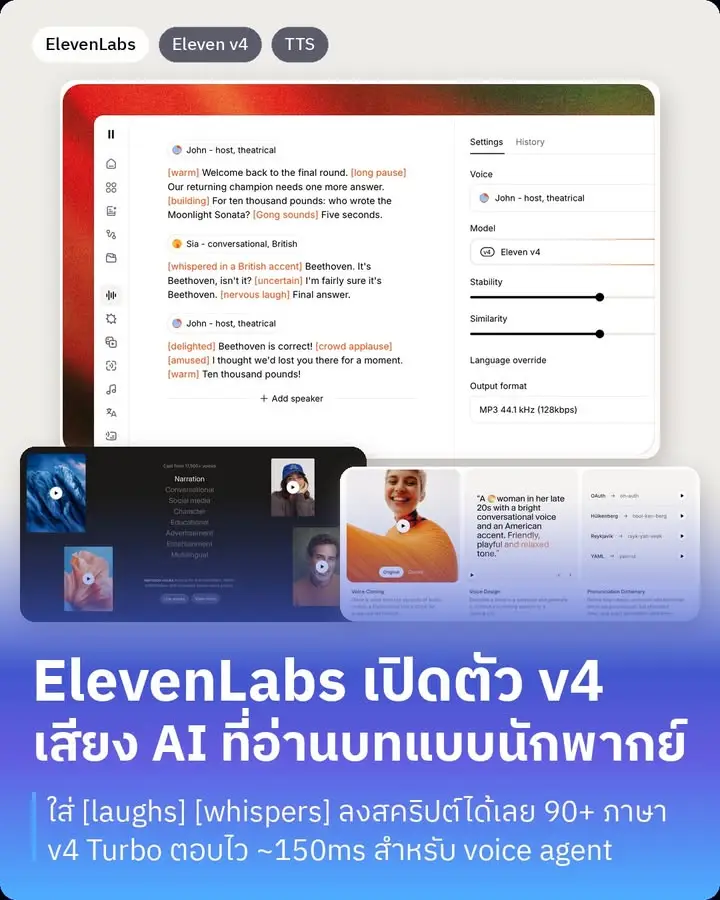
รุ่นนี้สร้างบนสถาปัตยกรรมใหม่ทั้งหมด ElevenLabs บอกว่ามันอ่านสคริปต์แบบนักพากย์ รู้ว่าใครกำลังพูด เพิ่งเกิดอะไรขึ้น และแต่ละประโยคควรออกมาอารมณ์ไหน
ที่ผมชอบคือเราเขียนกำกับลงไปในสคริปต์ได้เลย เช่น [laughs] [whispers] หรือเสียงประกอบอย่าง [door slams] เขาบอกว่า v4 ทำตามแท็กพวกนี้ได้แม่นกว่า v3 ใส่ผู้พูดหลายคนในบทเดียวได้ รองรับมากกว่า 90 ภาษา
งานยาวอย่างหนังสือเสียงก็ต่อกันเนียนขึ้น เขาใช้คำว่าเหมือนอัดเทคเดียวตั้งแต่หน้าแรกจนหน้าสุดท้าย และสั่งอ่านใหม่กี่รอบเสียงก็ยังเป็นคนเดิม ไม่เพี้ยนไปเรื่อย ๆ
Professional Voice Clone ที่ v3 ไม่รองรับก็กลับมาแล้วใน v4 ส่วนการโคลนเสียงแบบเร็วใช้เสียงแค่ 10 วินาที หรือจะพิมพ์บรรยายว่าอยากได้เสียงแบบไหนแล้วให้มันออกแบบเสียงให้ก็ได้ มีคลังเสียงให้เลือกมากกว่า 17,500 เสียง
อีกตัวคือ v4 Turbo ทำมาเพื่อ voice agent โดยเฉพาะ เวลาเฉลี่ยก่อนเริ่มพูดประมาณ 150 มิลลิวินาที ElevenLabs เทียบเองว่าเร็วกว่า Cartesia Sonic 3.6 อยู่ 112 มิลลิวินาที และเร็วกว่า GPT-4o mini TTS อยู่ 664 มิลลิวินาที ส่งข้อความเข้าไปทีละส่วนระหว่างที่ LLM ยังคิดไม่เสร็จ เสียงก็เริ่มออกมาก่อนจบประโยคแล้ว
ใช้ได้ทั้งในแอปและผ่าน API แพ็กเกจฟรีได้ 10,000 เครดิตต่อเดือน ส่วนแพ็กเกจเสียเงินเริ่ม 6 ดอลลาร์ต่อเดือน
ส่วนตัวผมอยากลองภาษาไทยมาก เพราะที่ผ่านมาเสียงไทยของ AI ยังแข็ง ๆ อยู่ ถ้ารุ่นนี้ใส่อารมณ์ภาษาไทยได้ดีจริง งานพากย์คลิปกับหนังสือเสียงไทยจะง่ายขึ้นเยอะ
ที่มา elevenlabs.io/v4
อยากใช้ AI กับงานจริงเป็นระบบ?
เรียน Claude Method — วิธีคิดและลงมือใช้ Claude/AI กับงานจริง ตั้งแต่วันแรก
📍 โพสต้นฉบับบน Facebook: AI กับ Peesamac