Docling คือเครื่องมือฟรีที่เอาไฟล์เอกสารกองโตของเรา…
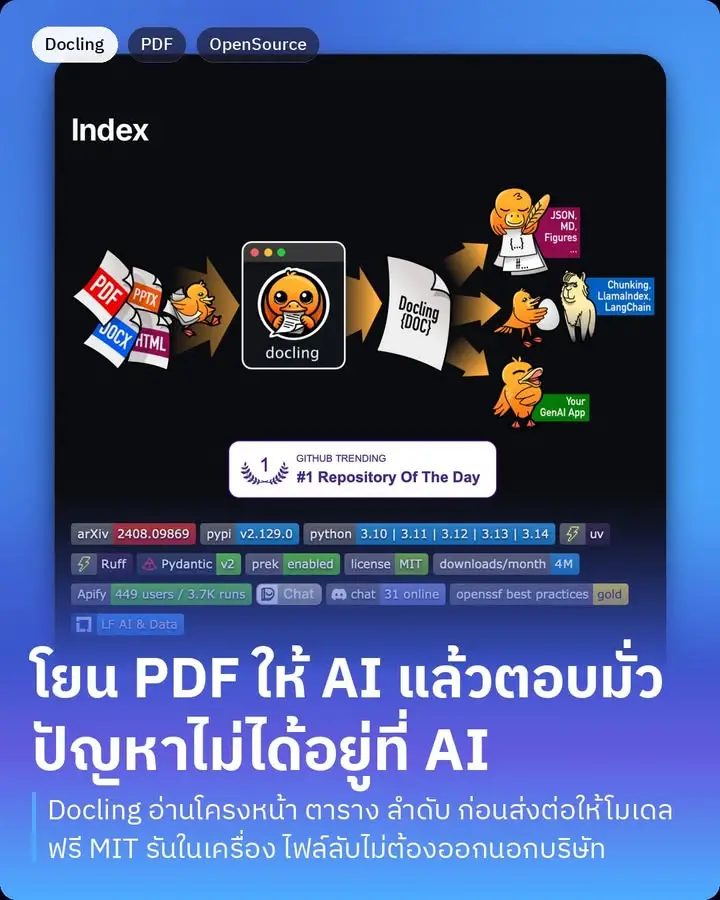
ใครที่เคยลองโยน PDF เข้า AI แล้วมันตอบมั่วจะเข้าใจปัญหานี้ดี เพราะ PDF ไม่ได้เก็บข้อมูลเป็นย่อหน้าแบบที่ตาเรามอง มันเก็บเป็นตัวอักษรลอยๆ พร้อมพิกัด พอดูดออกมาดื้อๆ ตารางจะแตก ลำดับการอ่านจะสลับ คอลัมน์ซ้ายขวาจะปนกัน สุดท้าย AI ก็ตอบจากข้อมูลที่เพี้ยนไปแล้ว
Docling แก้ตรงนี้ด้วยการเข้าใจโครงหน้ากระดาษก่อน รู้ว่าตรงไหนหัวข้อ ตรงไหนตาราง ลำดับการอ่านควรไปทางไหน มีสูตรคณิตหรือบล็อกโค้ดตรงไหน แล้วค่อยส่งออกเป็น Markdown HTML หรือ JSON ให้เอาไปต่อ
ที่ผมว่าเกินคาดคือของที่มันรับได้ ไม่ได้มีแค่ PDF แต่มี Word PowerPoint Excel HTML EPUB อีเมลทั้ง eml และ msg รูปสแกน LaTeX ไฟล์ Apple Pages ไปจนถึงไฟล์เสียงกับวิดีโอที่มันถอดเป็นข้อความให้พร้อมดึงภาพนิ่งตัวแทนออกมา ล่าสุดยังอ่านกราฟแท่งกราฟวงกลมแล้วแปลงกลับเป็นตารางได้ด้วย
จุดที่ผมชอบที่สุดคือรันในเครื่องตัวเองได้ทั้งหมด ไฟล์สัญญา ไฟล์เงินเดือน ไฟล์ลูกค้า ไม่ต้องอัปขึ้นเว็บใคร แล้วมันต่อตรงเข้า LangChain LlamaIndex Haystack ได้เลย หรือจะเปิดเป็น MCP server ให้ agent เรียกใช้ก็ได้
ตัวเลขก็ไม่ธรรมดา ผมเช็คจาก GitHub กับ PyPI เองตอนนี้ ดาวอยู่ที่ราว 67,300 ดวง fork อีกเกือบ 4,900 และเดือนที่ผ่านมามีคนโหลดไปใช้เกือบ 4 ล้านครั้ง ทีมที่เริ่มทำคือทีม AI for knowledge ของ IBM Research ที่ซูริก ตอนนี้ย้ายไปอยู่ใต้มูลนิธิ LF AI and Data แล้ว
เรื่องสัญญาอนุญาตผมเปิดไฟล์ LICENSE อ่านเองไม่ได้ดูแค่ป้ายบน README เป็น MIT จริง ใช้ในงานบริษัทได้สบาย แต่มีข้อควรรู้อยู่นิดคือถ้าไปเรียกโมเดลเสริมอย่างตัวอ่านภาพหรือตัวถอดเสียง ต้องไปดูสัญญาของโมเดลนั้นแยกอีกที ไม่ได้เหมาว่า MIT ทั้งหมด
เริ่มใช้ก็ง่ายมาก pip install docling แล้วสั่ง docling ตามด้วยลิงก์หรือพาธไฟล์ เดี๋ยวมันคายไฟล์ Markdown ออกมาให้ในโฟลเดอร์นั้นเลย ใครกำลังจะทำระบบถามตอบจากเอกสารในองค์กร ผมว่าเริ่มจากตัวนี้คุ้มกว่าไปเขียนตัวแกะ PDF เอง
อยากใช้ AI กับงานจริงเป็นระบบ?
เรียน Claude Method — วิธีคิดและลงมือใช้ Claude/AI กับงานจริง ตั้งแต่วันแรก
📍 โพสต้นฉบับบน Facebook: AI กับ Peesamac