Claude Sonnet 5.5 มาแล้วครับ รุ่นกลางตัวใหม่จาก Anthropic…
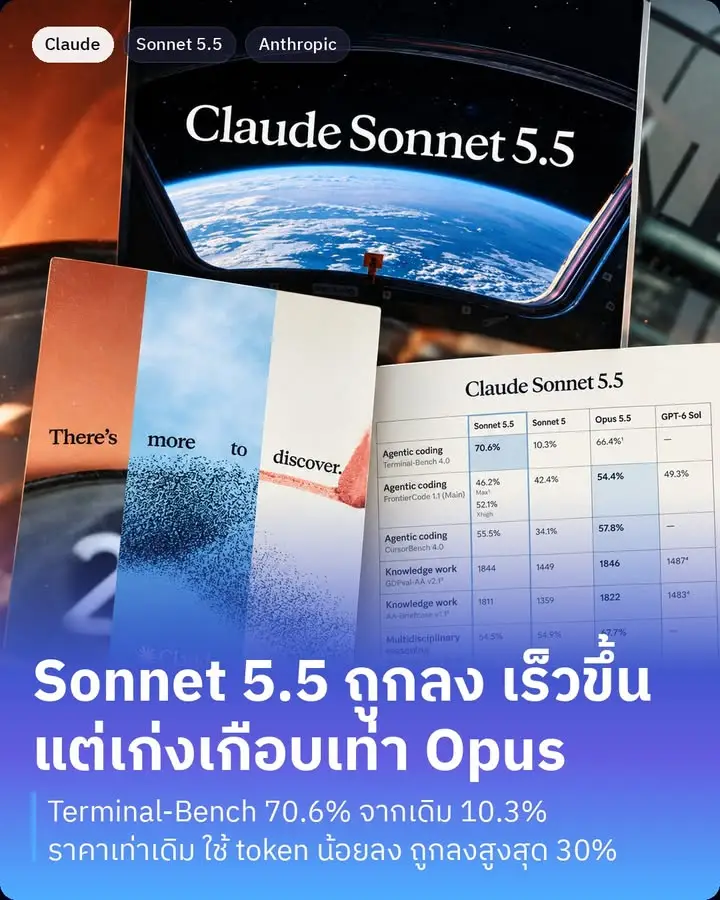
ตัวเลขที่ผมเห็นแล้วต้องอ่านซ้ำคือ Terminal-Bench 4.0 (เทสเขียนโค้ดแบบ agent ใน command line) Sonnet 5.5 ได้ 70.6% ส่วน Sonnet 5 รุ่นก่อนได้แค่ 10.3% แถมสูงกว่า Opus 5.5 ที่ได้ 66.4% ด้วย
งาน knowledge work ก็ใกล้กันมาก GDPval-AA ที่วัดงานจริง 44 อาชีพ Sonnet 5.5 ได้ 1844 ส่วน Opus 5.5 ได้ 1846 ห่างกันแค่ 2 แต้ม ส่วน computer use บน OSWorld ได้ 80.1% เทียบกับ Opus ที่ 81.8%
ราคาเท่า Sonnet 5 เดิมเป๊ะ คือ $2 ต่อล้าน input token และ $10 ต่อล้าน output token แต่ใช้ token น้อยลงเยอะเพื่อทำงานเดียวกัน Anthropic บอกว่าในหลายเทส Sonnet 5.5 ที่ effort ระดับ Low หรือ Medium ทำคะแนนชนะคะแนนดีที่สุดของ Sonnet 5 ได้ ด้วยค่าใช้จ่ายราวหนึ่งในสิบ
เขาวางตำแหน่งไว้ชัดว่า Sonnet 5.5 เก่งงานที่ขอบเขตชัด งานประจำวัน แก้บั๊ก และทำเอกสาร สไลด์ สเปรดชีตให้เนี้ยบ มีเทสภายในที่ให้เอกสารผลประกอบการรายไตรมาสกับบทถอดเสียง earnings call ของบริษัทมหาชนจริง พร้อม slide template แล้วสั่งทำสไลด์สรุป 10 หน้า ผู้เชี่ยวชาญ 2 คนดูแล้วบอกว่า draft แรกส่งได้เลย
แต่ Anthropic ก็พูดตรงๆ ว่างานซับซ้อนปลายเปิดที่ต้องใช้วิจารณญาณยาวๆ Opus 5.5 ยังเหนือกว่าชัดเจน คะแนน benchmark เป็นแค่มุมเดียว
เกร็ดสนุกคือมันเป็น Sonnet รุ่นแรกที่เล่น Pokémon Red จบได้จากการดู screenshot อย่างเดียว และ Haiku 5.5 จะตามมาในอีกไม่กี่สัปดาห์
ผมว่านี่คือข่าวดีของสายใช้งานทุกวันมากกว่าสายไล่ benchmark ครับ ใน Claude app กับ Claude Code ค่า effort default คือ Medium ซึ่งเป็นระดับที่ Anthropic บอกว่าชนะ Sonnet 5 ได้ด้วยต้นทุนต่ำกว่ามาก งานทั่วไปเลือก Sonnet 5.5 ส่วนงานยากจริงๆ ค่อยสลับไป Opus
ที่มา: https://www.anthropic.com/claude-sonnet-5-5
อยากใช้ AI กับงานจริงเป็นระบบ?
เรียน Claude Method — วิธีคิดและลงมือใช้ Claude/AI กับงานจริง ตั้งแต่วันแรก
📍 โพสต้นฉบับบน Facebook: AI กับ Peesamac